Tekst i pisanie
Limity znaków: strona maszynopisu, SMS, post na X i meta description
Ten sam tekst ma 1800 znaków ze spacjami i 1521 bez nich, a jako SMS z polskimi literami zajmuje trzy wiadomości. Wynik zależy od tego, co dokładnie liczy limit, więc najpierw ustal jednostkę, a dopiero potem pilnuj liczby.
- Redakcja HNarzędzi
- Publikacja:
Limit znaków brzmi jednoznacznie, dopóki nie trzeba go sprawdzić. Zleceniodawca pisze „do 5 stron”, formularz ucina opis po 500 znakach, post na X nie chce się opublikować, a SMS przychodzi w trzech częściach. Za każdym razem „znak” oznacza coś trochę innego. Poniżej kolejność sprawdzania razem z pomiarami w liczniku znaków.
Najpierw ustal, co jest jednostką
| Gdzie pada limit | Co się liczy | Uwaga |
|---|---|---|
| Strona maszynopisu, arkusz wydawniczy | znaki ze spacjami | liczba stron to znaki ze spacjami ÷ 1800 |
| Opis w formularzu, pole w CMS | zwykle wszystkie znaki, ze spacjami | zależy od systemu; sprawdź komunikat przy polu |
| SMS | jednostki kodowania (septety GSM-7 albo jednostki UTF-16) | polska litera zmienia kodowanie całej wiadomości |
| Post na X | ważona długość, nie liczba znaków | emoji liczy się za 2, link za 23 |
| Meta description i tytuł strony w Google | brak limitu znaków | wynik jest przycinany do szerokości ekranu |
Licznik pokazuje liczbę znaków ze spacjami i bez, strony maszynopisu, części SMS i trzy paski z orientacyjnymi długościami. Reszta tego poradnika wyjaśnia, jak czytać te liczby i gdzie się rozchodzą z regułami konkretnych serwisów.
Znaki ze spacjami i bez spacji
W liczniku „Znaki ze spacjami” to wszystkie znaki tekstu, także spacje, tabulatory i znaki nowej linii. „Znaki bez spacji” pomija wszystkie białe znaki. Różnica jest spora. Zrobiliśmy syntetyczny tekst testowy po polsku, ułożony z losowych słów na stałym ziarnie (skrypt scripts/guide-fixtures/character-limits.mjs), o długości dokładnie 1800 znaków ze spacjami. Licznik pokazał:
- 1800 znaków ze spacjami,
- 1521 znaków bez spacji,
- 280 słów i 1 stronę maszynopisu.
W tym tekście spacje to 279 znaków, czyli około 15% długości. Tekst o 10 000 znaków ze spacjami miałby w takiej proporcji około 8450 bez spacji, więc zapytaj zamawiającego, której wersji używa. Gdy nie dostaniesz odpowiedzi, podaj w ofercie obie liczby.
Strona znormalizowana 1800 znaków
Strona maszynopisu, zwana też stroną znormalizowaną, to 1800 znaków ze spacjami (30 wierszy po 60 znaków). Nie znaleźliśmy ustawy ani normy, która by ją definiowała, więc traktujemy ją jako konwencję wydawniczą. Używają jej wydawnictwa w wytycznych dla autorów. Na przykład Wydawnictwo Instytutu Historii PAN w wytycznych dla autorów liczy streszczenia w stronach po 1800 znaków ze spacjami, a objętość książki w arkuszach wydawniczych po 40 tys. znaków ze spacjami i przypisami (sprawdzone w październiku 2026). To około 22 stron, bo 40 000 ÷ 1800 = 22,2.
Ta sama instrukcja podpowiada, jak liczyć w Wordzie: „Recenzja”, potem „Statystyka wyrazów” z zaznaczoną opcją dołączenia pól tekstowych, przypisów dolnych i końcowych. Inne wydawnictwa mogą przypisów nie wliczać, więc wytyczne konkretnego wydawcy mają pierwszeństwo.
Strona tłumaczenia przysięgłego to osobna jednostka
Przy tłumaczeniach poświadczonych strona ma inną długość niż 1800. Rozporządzenie Ministra Sprawiedliwości w sprawie wynagrodzenia za czynności tłumacza przysięgłego liczy stronę jako 25 wierszy po 45 znaków, czyli 1125 znaków. Za znaki uznaje widoczne znaki drukarskie i uzasadnione przerwy między nimi (tekst jednolity z 2021 r. w bazie Sejmu, § 8; nie sprawdzaliśmy późniejszych zmian, więc przed wyceną zajrzyj do aktualnego tekstu w ISAP). Licznik tej strony nie liczy: pokazuje wyłącznie strony po 1800 znaków. Dla tłumaczenia przysięgłego podziel wynik przez 1125 samodzielnie. Licznik liczy wszystkie spacje, a rozporządzenie tylko uzasadnione przerwy, więc taki wynik jest przybliżeniem.
Dlaczego programy liczą ten sam tekst różnie
Przyczyny są trzy: co uznajemy za „jeden znak”, co wliczamy do tekstu i czy tekst został wcześniej znormalizowany.
Co licznik uznaje za jeden znak
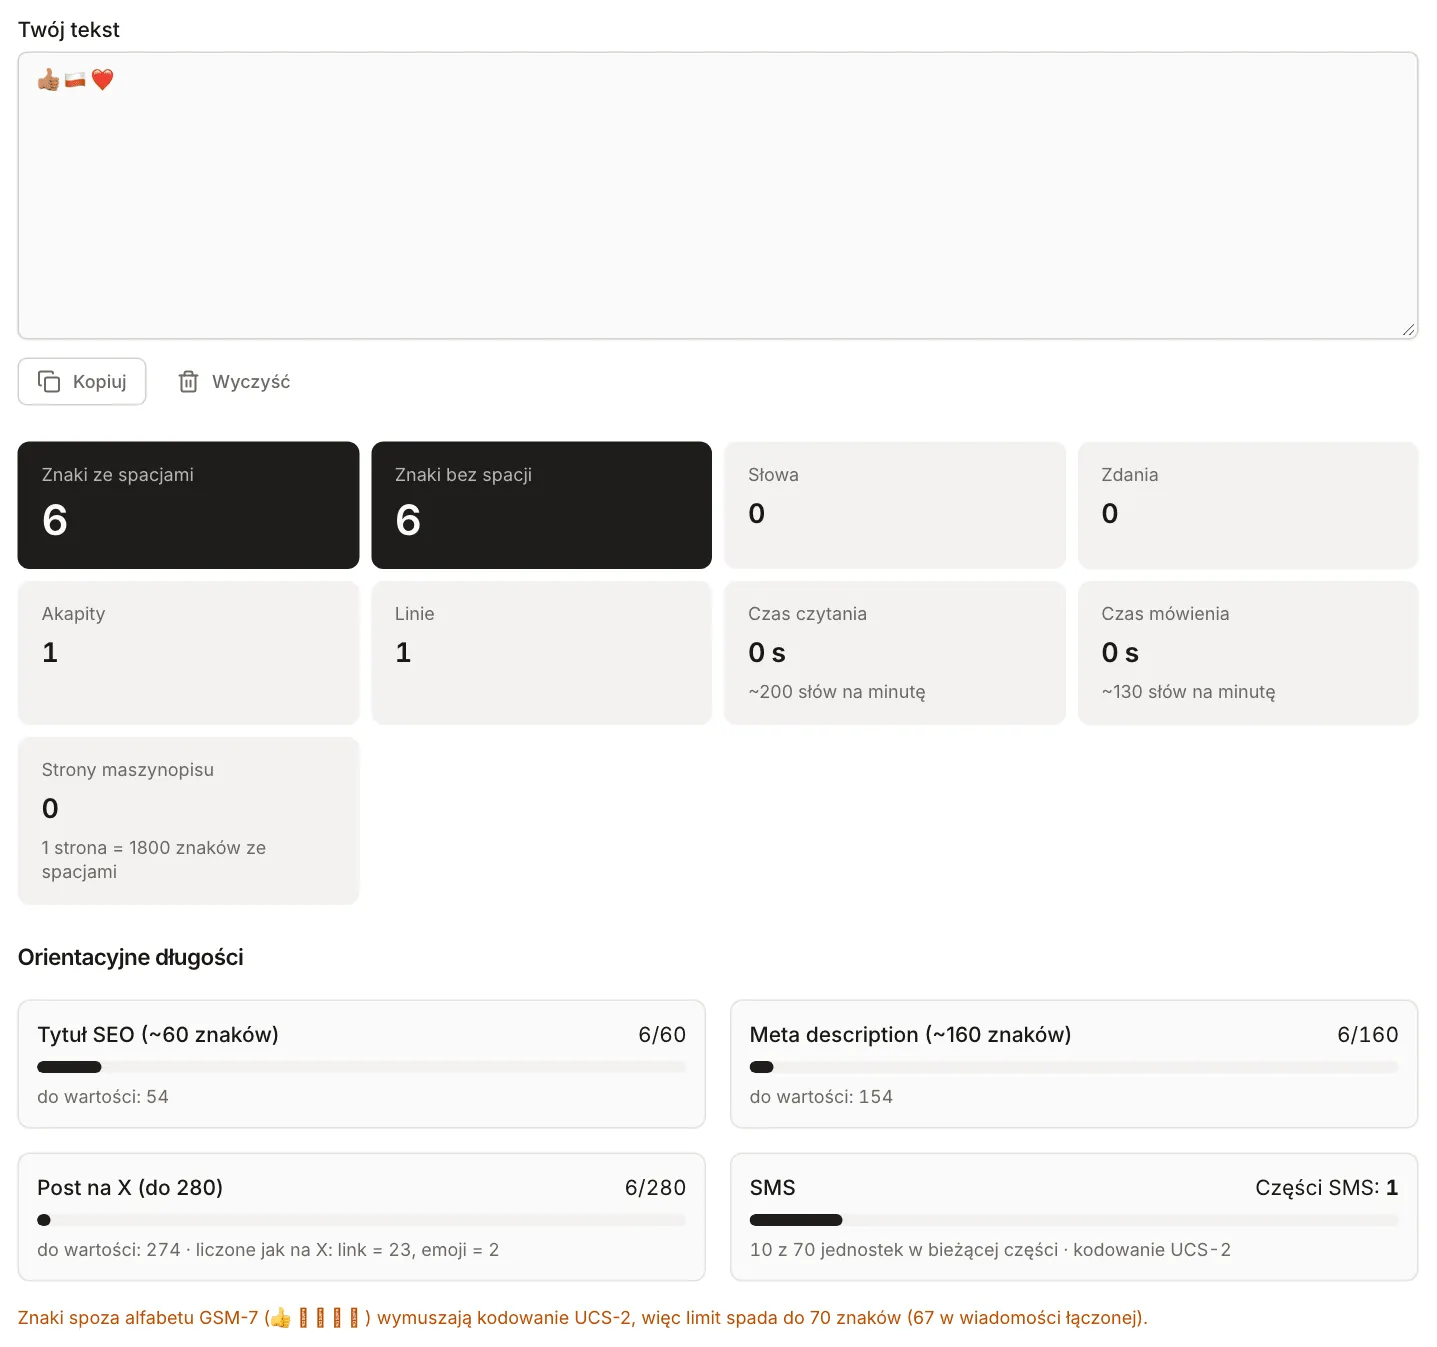
Kod licznika normalizuje tekst do formy NFC, a potem liczy punkty kodowe Unicode (Array.from). Nie liczy grafemów, czyli symboli widzianych przez człowieka jako jeden znak. Dla polskich liter to bez różnicy, ale emoji potrafią składać się z kilku punktów kodowych. Wpisaliśmy do licznika kilka przykładów, a obok dopisaliśmy miary policzone w Node (grafemy z Intl.Segmenter, jednostki UTF-16, bajty UTF-8):
| Tekst | Licznik | Grafemy (Node) | UTF-16 (Node) | UTF-8, bajty (Node) |
|---|---|---|---|---|
| Zażółć gęślą jaźń | 17 | 17 | 17 | 26 |
| 👍 | 1 | 1 | 2 | 4 |
| 👍🏽 (kciuk z odcieniem skóry) | 2 | 1 | 4 | 8 |
| 🇵🇱 (flaga) | 2 | 1 | 4 | 8 |
| 👨👩👧 (rodzina) | 5 | 1 | 8 | 18 |
| 1️⃣ (klawisz z cyfrą) | 3 | 1 | 3 | 7 |
| ❤️ | 2 | 1 | 2 | 6 |
Rodzina to trzy osoby sklejone dwoma niewidocznymi znakami łączącymi, więc licznik pokazuje 5, choć na ekranie jest jeden symbol. Program liczący grafemy pokaże 1, a program liczący jednostki UTF-16 (tak działa length w JavaScripcie) pokaże 8. Żadna z tych liczb nie jest błędna, bo każda odpowiada innej definicji znaku.
Normalizacja ma znaczenie przy tekście skopiowanym z innego systemu. Ten sam napis „Zażółć gęślą jaźń” zapisany w formie rozłożonej (NFD: litera i osobny znak akcentu) ma 25 punktów kodowych. Licznik normalizuje go do NFC i pokazuje 17 znaków oraz 3 słowa. Program, który tego nie robi, policzy więcej znaków.
Co wlicza się do tekstu
Niewidoczne znaki zmieniają wynik bez zmiany wyglądu. Cztery warianty tej samej treści w liczniku:
| Tekst | Znaki ze spacjami | Znaki bez spacji |
|---|---|---|
w domu i w pracy (zwykłe spacje) |
16 | 12 |
| to samo z twardymi spacjami po „w” i „i” | 16 | 12 |
| to samo ze spacją zerowej szerokości (U+200B) po „domu” | 17 | 13 |
dwie linie rozdzielone Enterem (linia 1 i linia 2) |
15 | 12 |
Twarda spacja liczy się jak spacja, więc w wersji „bez spacji” znika. Spacja zerowej szerokości nie jest uznawana za biały znak, więc licznik liczy ją jako zwykły znak i podnosi wynik w obu wierszach. Tekst skopiowany ze strony WWW albo z PDF-a czasem ma takie znaki, a nie widać ich gołym okiem. Znak nowej linii liczy się jako jeden znak ze spacjami.
Edytory różnią się też tym, co wchodzi do statystyki. Według pomocy Google Dokumenty Google pomijają w liczniku nagłówki, stopki i przypisy dolne. Kopiowanie tekstu do licznika zamiast czytania statystyki z edytora daje liczbę z tego, co faktycznie wkleiłeś.
SMS: jedna polska litera i limit spada ze 160 do 70
Limity opisuje norma 3GPP TS 23.038, dostępna jako ETSI TS 123 038 V17.0.0 (2022-04) (sprawdzone w październiku 2026). Wiadomość w domyślnym alfabecie GSM 7-bitowym ma do 160 znaków, a w kodowaniu UCS2 do 140 oktetów, czyli 70 znaków. Znaki z tablicy rozszerzeń (np. €, nawiasy kwadratowe i klamrowe, ^, ~, \, |) zajmują dwa miejsca. Tablice narodowych wersji alfabetu obejmują w tym wydaniu m.in. turecki, hiszpański i portugalski, a polskiego nie ma.
Polskie litery ą, ć, ę, ł, ń, ó, ś, ź, ż nie należą do alfabetu GSM-7, więc już jedna z nich przełącza całą wiadomość na UCS-2. Licznik pokazuje to wprost: liczbę części, zajętość bieżącej części i pomarańczowe ostrzeżenie z listą znaków, które wymusiły UCS-2. Wiadomość łączona z kilku części ma na część mniej miejsca, bo dochodzi nagłówek. Licznik przyjmuje 153 znaki w GSM-7 i 67 w UCS-2 (te dwie liczby wynikają z kodu narzędzia, nie z przytoczonego dokumentu).
Przykład na syntetycznym SMS-ie przypominającym o wizycie, 144 znaki ze spacjami:
Dzień dobry, przypominamy o wizycie jutro o 9:30. Prosimy o potwierdzenie odpowiedzią TAK lub o kontakt z recepcją, jeśli termin się nie zgadza.
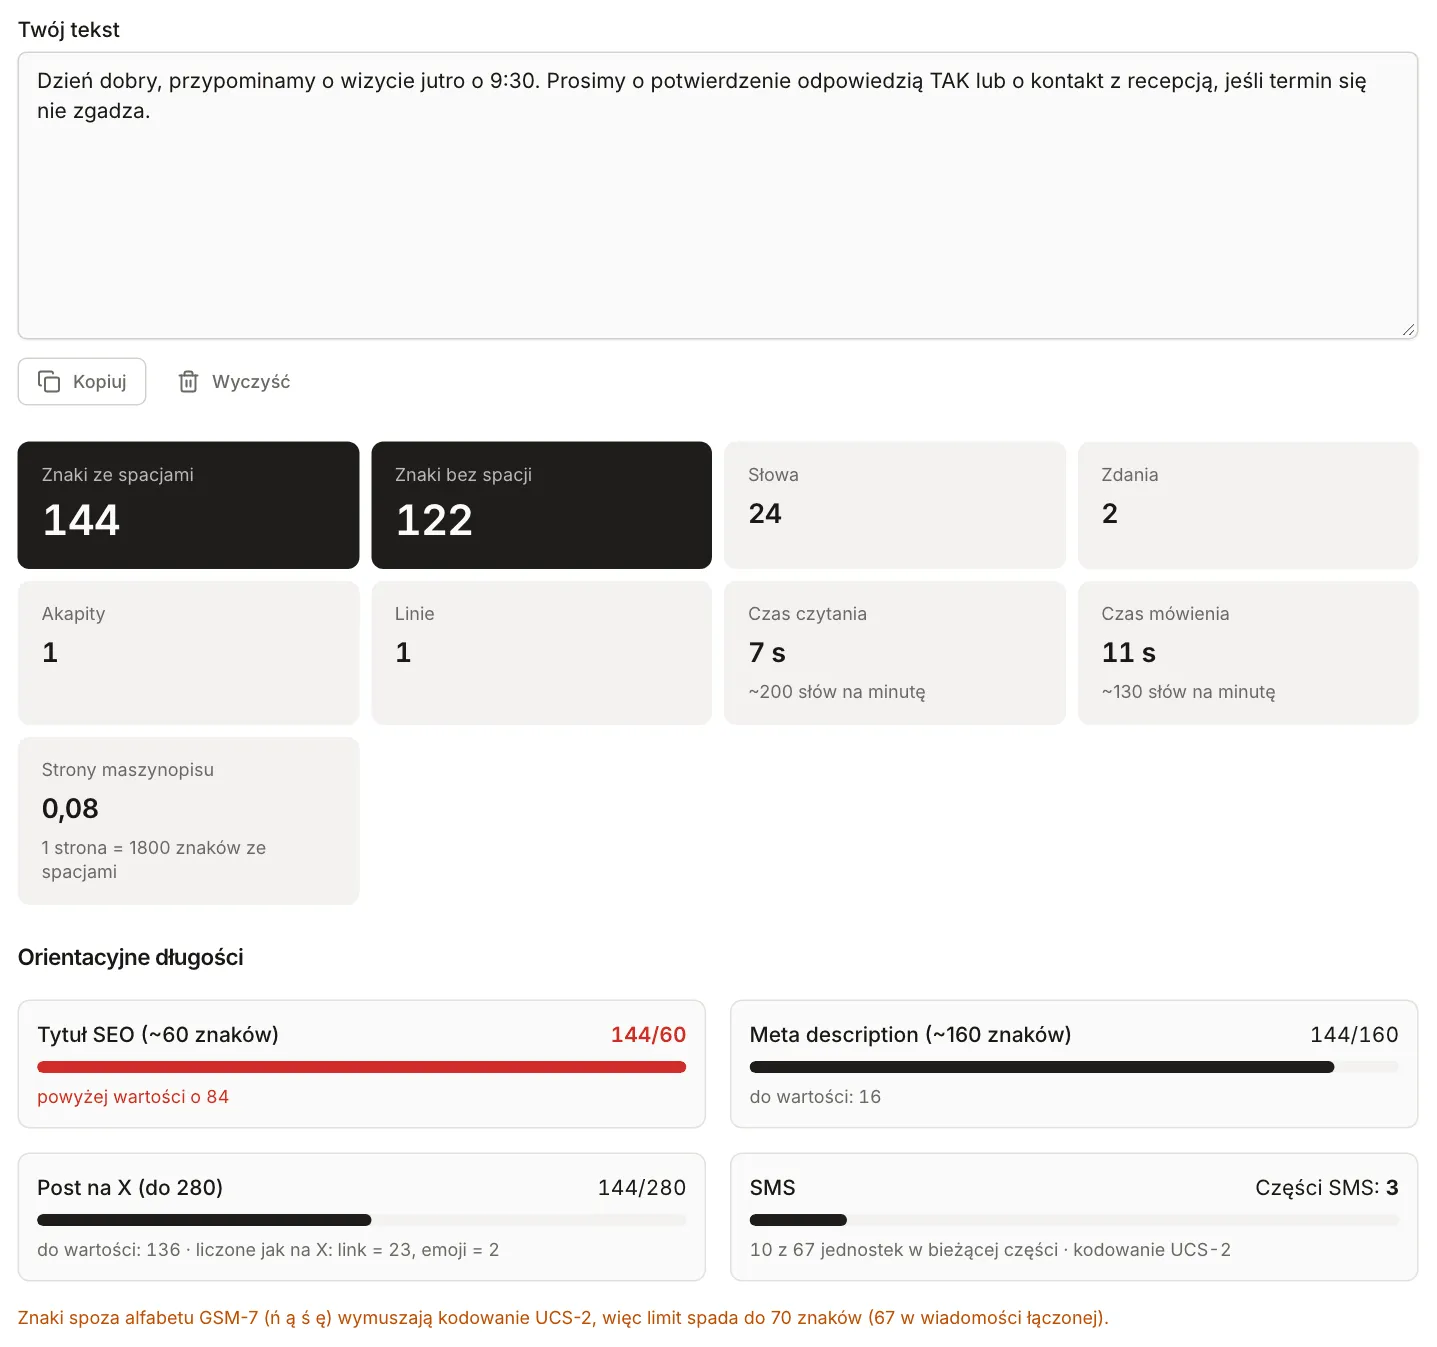
Licznik pokazał 3 części, kodowanie UCS-2 i 10 jednostek w ostatniej części (67 + 67 + 10 = 144). To samo bez pięciu ogonków (ń, ą, ą, ś, ę) miało 144 znaki, kodowanie GSM-7 i jedną część. Zamianę zrobiliśmy w narzędziu Usuwanie polskich znaków i wynik zgadzał się znak w znak z ręcznie przygotowaną wersją bez ogonków.
Granice, które sprawdziliśmy w liczniku:
| Tekst | Kodowanie | Części |
|---|---|---|
| 160 liter „a” | GSM-7 | 1 |
| 161 liter „a” | GSM-7 | 2 |
| 70 liter „ś” | UCS-2 | 1 |
| 71 liter „ś” | UCS-2 | 2 |
| 80 znaków € (160 septetów, bo każde € zajmuje 2) | GSM-7 | 1 |
| 81 znaków € | GSM-7 | 2 |
| 35 emoji 😀 (po 2 jednostki UTF-16) | UCS-2 | 1 |
| 36 emoji 😀 | UCS-2 | 2 |
Do UCS-2 przełączają też znaki, których nie widać jako „obcych”. Licznik uznał za spoza GSM-7 półpauzę (angielski SMS o 38 znakach, bez żadnej innej obcej litery, dostał z nią UCS-2), twardą spację, tabulator i spację zerowej szerokości. Krzywy apostrof z edytora tekstu zrobił to samo w angielskim SMS-ie o 107 znakach: z apostrofem prostym (can't) wiadomość zajęła 1 część, a z krzywym (can’t) 2 części. Tekst kopiowany z edytora często ma takie znaki typograficzne, więc przed wysyłką wklej go do licznika i sprawdź listę w ostrzeżeniu. Narzędzie do usuwania polskich znaków zamienia litery, ale krzywych cudzysłowów i pauz nie rusza.
Usunięcie ogonków kosztuje czytelność, a w oficjalnych wiadomościach część odbiorców uzna taki tekst za niedbały. Zamiast tego możesz skrócić treść do 70 znaków albo zaakceptować kilka części. Wybór zależy od kosztu wiadomości u Twojego operatora lub bramki SMS, a licznik tych cen nie zna. Bramki mogą też mieć własne reguły (zamianę znaków, dopisywanie nazwy nadawcy), więc po zmianie treści warto wysłać próbną wiadomość.
Posty i meta description: limity platform
X (Twitter)
Dokumentacja X o liczeniu znaków (sprawdzona w październiku 2026) opisuje limit 280 ważonych znaków:
- litery łacińskie, cyfry i znaki interpunkcyjne liczą się po 1,
- emoji liczą się po 2, także złożone (kciuk z odcieniem skóry, rodzina),
- każdy link liczy się jako 23 znaki, bez względu na długość,
- długość liczy się po normalizacji do NFC.
Polskie litery mają wagę 1: w konfiguracji biblioteki twitter-text (config/v3.json), na którą powołuje się dokumentacja, zakres kodów od 0 do 4351 ma wagę 1, a domyślna waga innych znaków to 2.
Pasek „Post na X” w liczniku liczy według tych reguł. Normalizuje tekst do NFC, liczy emoji (cały symbol, także złożony) za 2, link za 23, a znaki spoza zakresów o wadze 1, na przykład chińskie, za 2. Linki wykrywa uproszczonym wzorcem: adresy zaczynające się od http:// lub https:// oraz domeny z popularnym końcem, np. example.com/sciezka. Domeny krajowe bez protokołu (np. .pl) uznaje za link tylko wtedy, gdy ma ścieżkę po ukośniku. Wzorzec nie zna pełnej listy domen z X, więc przy nietypowym adresie wynik może się rozminąć z X o różnicę między długością adresu a 23. Zestawienie dla tekstów testowych, z pomiaru w narzędziu (zgodność z regułami dokumentacji sprawdziliśmy rachunkiem, nie w aplikacji X):
| Tekst | Znaki w liczniku | Pasek „Post na X” |
|---|---|---|
| 140 emoji 😀 | 140 | 280/280 |
| 141 emoji 😀 | 141 | 282/280, za dużo |
| link z parametrami UTM, 113 znaków | 113 | 23/280 |
| Zażółć gęślą jaźń | 17 | 17/280 |
| „Nowość w narzędziach”, emoji 👍🏽 i link z UTM (137 punktów kodowych) | 137 | 47/280 |
| 漢字漢字 | 4 | 8/280 |
Pozostałe statystyki w liczniku (znaki ze spacjami, bez spacji, strony) nadal liczą emoji według punktów kodowych, więc przy poście na X czytaj pasek, a nie pierwszy kafelek.
Pomoc LinkedIna o tworzeniu postów (sprawdzona w październiku 2026) podaje, że post może mieć do 3000 znaków. Zasad liczenia emoji i linków strona nie opisuje, więc licznik pokaże tu liczbę znaków, ale nie rozstrzygnie sporu o ostatnie kilka.
Meta description i tytuł strony w Google
Google nie ustala limitu znaków dla meta description. Dokumentacja Search Central o snippetach (sprawdzona w październiku 2026) stwierdza, że długość opisu nie jest ograniczona, a fragment w wynikach jest skracany, zwykle zależnie od szerokości ekranu. Podobnie opisuje tytuł strony strona o linkach tytułowych: nie ma limitu długości, a wyświetlany tytuł jest przycinany do szerokości urządzenia. Google radzi unikać zbędnych, rozwlekłych tytułów, a długość opisu można ograniczyć znacznikiem max-snippet.
Paski „Tytuł SEO (~60 znaków)” i „Meta description (~160 znaków)” w liczniku to więc przybliżenia do planowania, nie reguła Google. Praktyczny wniosek: najważniejsze informacje wpisz na początku opisu. Jeśli część zostanie ucięta, nie przepadnie sens. Liczba znaków nie przewidzi też przycięcia dokładnie, bo „i” zajmuje mniej miejsca niż „w”, a ekran telefonu ma mniej miejsca niż komputer.
Kolejność sprawdzania
- Ustal jednostkę: znaki ze spacjami, bez spacji, jednostki SMS albo ważona długość posta. Zapisz też, czy do limitu wchodzą przypisy, nagłówki i podpis.
- Wklej tekst do licznika i odczytaj właściwą liczbę. Po wklejeniu z innego edytora zwróć uwagę na pomarańczowe ostrzeżenie (znaki spoza GSM-7) i na różnicę między „ze spacjami” a „bez”, bo ona zdradza dziwne białe znaki.
- Przy SMS-ie sprawdź liczbę części i ostrzeżenie, a potem zdecyduj: skrócić, usunąć ogonki albo zostawić.
- Przy poście na X czytaj pasek „Post na X”, a nie liczbę znaków. Gdy w poście jest adres w nietypowej formie (np. rzadka domena bez
https://), przelicz go ręcznie jako 23. - Tekst do Google napisz tak, żeby ucięcie nic nie psuło, a nie tak, żeby trafić w liczbę.
Czego licznik nie robi
- Statystyki znaków liczą punkty kodowe, nie grafemy. Złożone emoji mogą dać więcej znaków, niż widzisz symboli. Pasek „Post na X” liczy emoji jako symbol, po 2.
- Pasek „Post na X” rozpoznaje linki uproszczonym wzorcem i nie zna pełnej listy domen z X.
- Paski tytułu i meta description to wartości orientacyjne, nie limity Google.
- Strony tłumaczenia przysięgłego (1125 znaków) nie pokazuje. Wynik dla niej trzeba przeliczyć samodzielnie.
- Części SMS to wyliczenie z 160/153 i 70/67. Operator lub bramka mogą przetwarzać wiadomość inaczej.
- Tekst zostaje w przeglądarce i nie jest wysyłany na serwer.