Dla programistów
Błąd w JSON: jak znaleźć i poprawić najczęstsze problemy
Parser zgłasza „Unexpected token” albo „Nieoczekiwany znak” i nie mówi, co dokładnie jest nie tak. Sprawdź, co dla każdego z typowych błędów pokazuje walidator, jak czytać wskazaną linię i kolumnę oraz kiedy poprawny JSON i tak zmienia dane.
- Redakcja HNarzędzi
- Publikacja:
Błędy w JSON zwykle są jedną z kilkunastu typowych pomyłek: przecinek po ostatnim elemencie, pojedyncze cudzysłowy, klucz bez cudzysłowu, komentarz, NaN albo plik ucięty w połowie. Parsery zgłaszają je krótko („Unexpected token”), więc pomaga narzędzie, które wskaże linię, kolumnę i pokaże fragment ze znacznikiem. Wklej dokument do formatowania JSON, przeczytaj pierwszy błąd, popraw go i wklej ponownie. Dokument jest przetwarzany w przeglądarce i nie trafia na serwer.
Jak czytać linię, kolumnę i znak
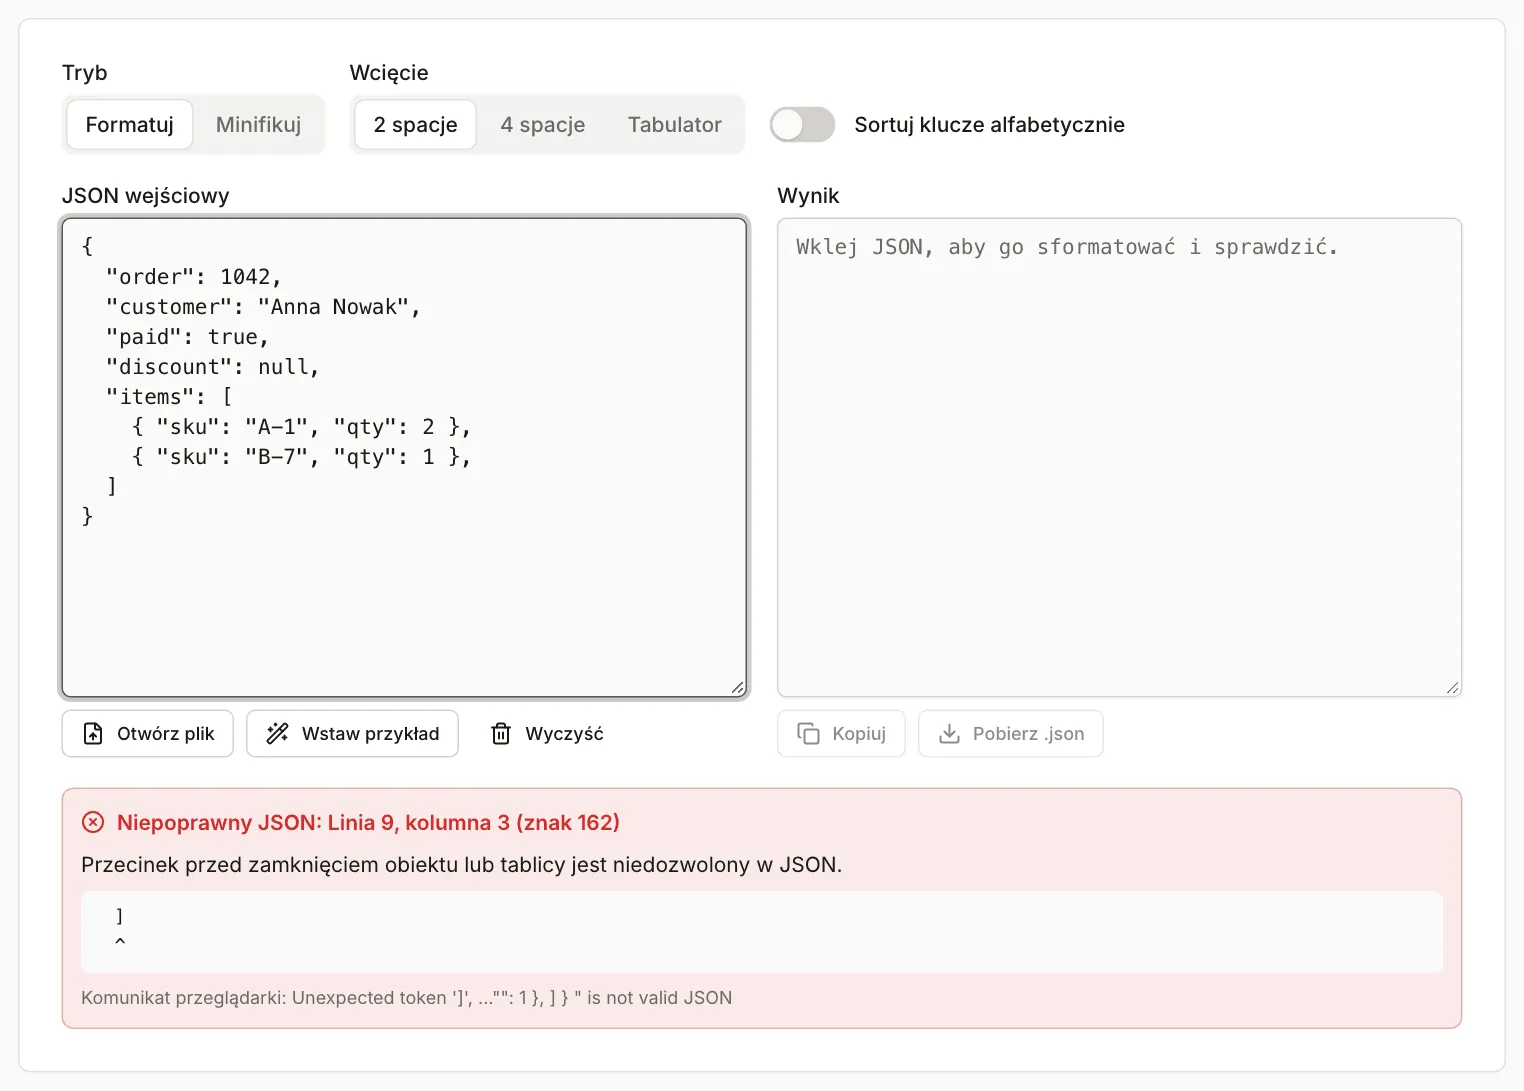
Narzędzie podaje trzy liczby, np. „Linia 9, kolumna 3 (znak 162)”. Linia i kolumna liczą się od 1. „Znak” to indeks liczony od 0 (pierwszy znak dokumentu to znak 0), taki sam jak w komunikacie przeglądarki („at position 162”). Pod linią z błędem narzędzie pokazuje znacznik ^.
Trzy rzeczy warto wiedzieć od razu:
- Walidator zatrzymuje się na pierwszym błędzie. Dokument z sześcioma pomyłkami wymaga sześciu poprawek (przykład poniżej).
- Wskazane miejsce to pierwszy znak, którego parser nie umie przyjąć, a nie zawsze miejsce pomyłki. Brakujący przecinek na końcu linii 3 jest zgłaszany na początku linii 4.
- Linijka „Komunikat przeglądarki” pod błędem pochodzi z silnika przeglądarki i jest po angielsku. Jej treść zależy od przeglądarki, a pomiary robiliśmy w Chromium. Linię, kolumnę i opis po polsku wylicza własny walidator narzędzia.
Co pokazuje walidator dla typowych błędów
Dokument testowy to syntetyczne zamówienie (10 linii, 165 bajtów). W każdym pliku z błędem zmieniliśmy dokładnie jedną rzecz i wkleiliśmy go do narzędzia. Pozycje są z interfejsu narzędzia (wersja PL).
| Co jest w pliku | Wskazana pozycja | Opis w narzędziu |
|---|---|---|
Przecinek po ostatnim elemencie tablicy ({ ... }, przed ]) |
linia 9, kolumna 3 (nawias ]) |
Przecinek przed zamknięciem obiektu lub tablicy jest niedozwolony |
Przecinek po ostatnim polu obiektu (], przed }) |
linia 10, kolumna 1 (nawias }) |
ten sam komunikat |
Pojedyncze cudzysłowy wokół wartości: 'Anna Nowak' |
linia 3, kolumna 15 | Nieoczekiwany znak, powinna być wartość |
Klucz bez cudzysłowu: paid: true |
linia 4, kolumna 3 | Oczekiwano nazwy klucza w podwójnym cudzysłowie |
Komentarz // w osobnej linii |
linia 2, kolumna 3 | Komentarze // i /* */ są niedozwolone w JSON |
Komentarz /* ... */ po przecinku |
linia 4, kolumna 17 | ten sam komunikat o komentarzach |
NaN, undefined albo Infinity jako wartość |
linia 5, kolumna 15 | Nieoczekiwany znak, powinna być wartość |
Typograficzne cudzysłowy wokół wartości: “Anna Nowak” |
linia 3, kolumna 15 | Nieoczekiwany znak, powinna być wartość |
| Typograficzne cudzysłowy wokół klucza | linia 3, kolumna 3 | Oczekiwano nazwy klucza w podwójnym cudzysłowie |
| Twarda spacja (U+00A0) po dwukropku | linia 4, kolumna 10 | Nieoczekiwany znak, powinna być wartość |
Niewidoczna spacja zerowej szerokości (U+200B) przed true |
linia 4, kolumna 11 | Nieoczekiwany znak, powinna być wartość |
| Brak przecinka między polami | linia 4, kolumna 3 | Oczekiwano przecinka lub zamknięcia obiektu |
Brak dwukropka: "paid" true |
linia 4, kolumna 10 | Oczekiwano dwukropka po nazwie klucza |
Zero wiodące: 01042 |
linia 2, kolumna 13 | Niepoprawna liczba |
+1042, .5 |
linia 2, kolumna 12 | Nieoczekiwany znak, powinna być wartość |
Liczba szesnastkowa 0x41 |
linia 2, kolumna 13 | Oczekiwano przecinka lub zamknięcia obiektu |
Ścieżka Windows "C:\Users\Anna" |
linia 3, kolumna 18 | Niepoprawna sekwencja ucieczki |
| Enter wewnątrz tekstu w cudzysłowie | linia 3, kolumna 20 | Niedozwolony znak sterujący, użyj \n |
Brakujący zamykający cudzysłów: "Anna Nowak, |
linia 3, kolumna 27 (koniec linii) | Niedozwolony znak sterujący w tekście |
Brakujący ] przed } |
linia 9, kolumna 1 | Oczekiwano przecinka lub zamknięcia tablicy |
Dwa dokumenty w jednym pliku albo tekst po zamykającym } |
linia 11, kolumna 1 | Nadmiarowe dane po zakończeniu dokumentu |
Odpowiedź HTML zamiast JSON (<!DOCTYPE html>) |
linia 1, kolumna 1 | Nieoczekiwany znak, powinna być wartość |
Co z tego wynika w praktyce:
- Komentarz ma własny opis i podpowiedź, co zrobić (usunąć go albo przenieść opis do osobnego klucza). Klucz bez cudzysłowu dostaje opis „Oczekiwano nazwy klucza…”, a komunikat przeglądarki dla obu błędów jest taki sam („Expected property name…”).
- Pojedyncze cudzysłowy wartości,
NaN,undefinediInfinityteż mają wspólny opis. Rozpoznasz je po pierwszym znaku pod^. - Brakujący zamykający cudzysłów jest zgłaszany jako problem z końcem linii, a nie z cudzysłowem. Gdy komunikat mówi o znaku sterującym, a w linii nie ma żadnego Entera, sprawdź, czy tekst zamyka się cudzysłowem.
- Przy brakującym przecinku i brakującym nawiasie narzędzie wskazuje następną linię. Przyczyna leży na końcu poprzedniej.
Znaki, których nie widać
Twarda spacja, spacja zerowej szerokości i cudzysłowy typograficzne wchodzą do JSON zwykle przez kopiowanie z edytora tekstu, dokumentu lub strony internetowej. Walidator wskazuje je poprawnie (patrz tabela), ale na ekranie wyglądają niewinnie: pod ^ stoi coś, co przypomina zwykłą spację albo nie widać nic.
Wskazówka z naszych pomiarów: gdy w komunikacie przeglądarki znak w apostrofach wygląda jak spacja albo apostrofy są puste (Unexpected token ' '), a linia wygląda poprawnie, to jest niewidoczny znak. Usuń fragment wskazany przez ^ i wpisz go ponownie z klawiatury. Typograficzne cudzysłowy “ i ” zamień na zwykłe ".
BOM na początku pliku
BOM (U+FEFF, w UTF-8 trzy bajty EF BB BF) to znacznik na początku pliku, który dodają niektóre programy. Plik testowy z BOM zachowuje się tak:
- Narzędzie do formatowania ignoruje pojedynczy BOM na początku i pokazuje „Poprawny JSON”. Gdy BOM jest w wklejonym tekście, pod spodem pojawia się informacja: „Tekst zaczyna się od znaku BOM (U+FEFF). Wynik go nie zawiera, bo część programów odrzuca JSON z BOM”. Przy pliku wczytanym przyciskiem „Otwórz plik” informacji nie ma, bo przeglądarka usuwa BOM już przy odczycie pliku. Dwa BOM-y z rzędu dają błąd w linii 1, kolumnie 1.
- Pobrany wynik („dane.json”, 196 bajtów) zaczyna się od
{, bez BOM. Sformatowanie i pobranie pliku usuwa więc ten znak. - Ten sam plik w Node.js 24 (
JSON.parsena tekście zfs.readFileSync(plik, 'utf8')) kończy się błędem „Unexpected token”, a w Pythonie 3.14 (json.load) komunikatem „Unexpected UTF-8 BOM (decode using utf-8-sig)”. Pomiary w Node i Pythonie zrobiliśmy lokalnie, poza narzędziem.
Dlatego sam „Poprawny JSON” w formatterze nie gwarantuje, że wczyta go każdy program. RFC 8259 (sekcja 8.1) zabrania dodawania BOM do JSON wysyłanego między systemami i pozwala parserom go pominąć, ale nie wymaga tego. Jeśli plik ma trafić do aplikacji, użyj pobranego wyniku.
Konwerter CSV-JSON w kierunku JSON do CSV usuwa BOM także z wklejonego tekstu, więc tekst z BOM przechodzi bez błędu.
Ucięty plik
Plik urwany w środku pobierania, wklejony fragment albo odpowiedź API przerwana limitem znaków kończą się tak samo: parser dochodzi do końca tekstu i brakuje mu zamknięcia. Dla pliku uciętego po { "sku": "B-7" narzędzie wskazało linię 8, kolumnę 19 (to miejsce, gdzie plik się kończy) i napisało „Nieoczekiwany koniec danych. Brakuje zamknięcia nawiasu, cudzysłowu lub wartości”. Dla pliku urwanego w środku tekstu "Anna Now wynik jest taki sam, z kolumną 24 w linii 3.
Jeśli „Nieoczekiwany koniec danych” pojawia się przy pliku, który nie powinien być ucięty, sprawdź, czy całość się skopiowała i czy dokument ma tyle samo { co } oraz [ co ]. Gdy plik pobrałeś lub dostałeś od kogoś, pobierz go jeszcze raz.
Podobny objaw ma odpowiedź serwera, która w ogóle nie jest JSON-em. Wklejony tekst zaczynający się od <!DOCTYPE html> daje błąd w linii 1, kolumnie 1, bo pierwszy znak to <. Zwykle oznacza to stronę błędu (np. 502 albo przekierowanie do logowania), więc sprawdź adres i odpowiedź serwera, a nie składnię.
JSON, JSON5 i obiekt JavaScript
Wiele „błędów w JSON” to poprawny zapis w innym formacie. Obiekt JavaScript pozwala na klucze bez cudzysłowu, pojedyncze cudzysłowy, komentarze, przecinek na końcu i NaN. JSON tego nie dopuszcza.
- RFC 8259 (grudzień 2017, Internet Standard STD 90, sprawdzone w październiku 2026) opisuje gramatykę, w której elementy rozdziela przecinek, a po ostatnim go nie ma. Reguły na komentarze w niej nie ma. Liczby są dziesiętne, bez zer wiodących, a
NaNiInfinitysą niedozwolone (sekcja 6). - ECMA-404 w wydaniu drugim z grudnia 2017 (sprawdzone w październiku 2026) opisuje tę samą składnię.
- JSON5 (sprawdzone w październiku 2026) jest osobnym formatem. Dodaje komentarze, przecinek na końcu, pojedyncze cudzysłowy, klucze bez cudzysłowu, liczby szesnastkowe,
+1,.5orazInfinityiNaN. Walidator JSON uzna taki dokument za błędny.
Co z tym zrobić: jeśli plik jest konfiguracją z komentarzami, a program dopuszcza JSON5 lub JSONC, zostaw go. Jeśli ma trafić do API albo JSON.parse, usuń komentarze, ujmij klucze w ", zamień ' na ", usuń końcowe przecinki i zamień NaN oraz undefined na null albo pomiń to pole. Wartości null używaj świadomie, bo zmienia znaczenie danych.
Przykład: dokument z sześcioma błędami w siedmiu rundach
Dokument testowy jest zapisany jak mały obiekt JavaScript:
{
  // sklep
  name: 'Anna',
  "tax": NaN,
  "tags": ["a", "b",],
}
Wklejaliśmy go do narzędzia i po każdym komunikacie poprawialiśmy jedną rzecz:
| Runda | Wynik narzędzia | Poprawka |
|---|---|---|
| 1 | linia 2, kolumna 3: oczekiwano nazwy klucza (komentarz //) |
usuń linię z komentarzem |
| 2 | linia 2, kolumna 3: oczekiwano nazwy klucza (name) |
zamień na "name" |
| 3 | linia 2, kolumna 11: nieoczekiwany znak (') |
zamień 'Anna' na "Anna" |
| 4 | linia 3, kolumna 10: nieoczekiwany znak (N z NaN) |
zamień NaN na null |
| 5 | linia 4, kolumna 21: przecinek przed zamknięciem tablicy | usuń przecinek przed ] |
| 6 | linia 5, kolumna 1: przecinek przed zamknięciem obiektu | usuń przecinek po ] |
| 7 | Poprawny JSON, 3 klucze, głębokość 2, 85 B | gotowe |
Pierwsze dwie rundy mają to samo wskazanie (linia 2, kolumna 3), bo po usunięciu komentarza zaczyna się tam klucz bez cudzysłowu.
Poprawny JSON nie oznacza niezmienionych danych
Gdy walidator pokazuje „Poprawny JSON”, składnia jest w porządku. Wartości mogą się jednak różnić od wejścia, bo narzędzie czyta dokument przez JSON.parse i zapisuje go przez JSON.stringify. Liczby są wtedy 64-bitowymi liczbami zmiennoprzecinkowymi. W takich przypadkach pod zielonym komunikatem pojawiają się żółte ostrzeżenia. Plik testowy z liczbami dał takie wyniki:
| Na wejściu | Na wyjściu | Ostrzeżenie |
|---|---|---|
9007199254740993 (2^53 + 1) |
9007199254740992 |
tak (linia 2, kolumna 9) |
12345678901234567890 |
12345678901234567000 |
tak (linia 3, kolumna 10) |
0.1000000000000000055 |
0.1 |
tak (linia 7, kolumna 11) |
1e400 |
null |
tak |
9007199254740991 (2^53 - 1) |
bez zmian | nie |
1.10 |
1.1 |
nie |
1e2 |
100 |
nie |
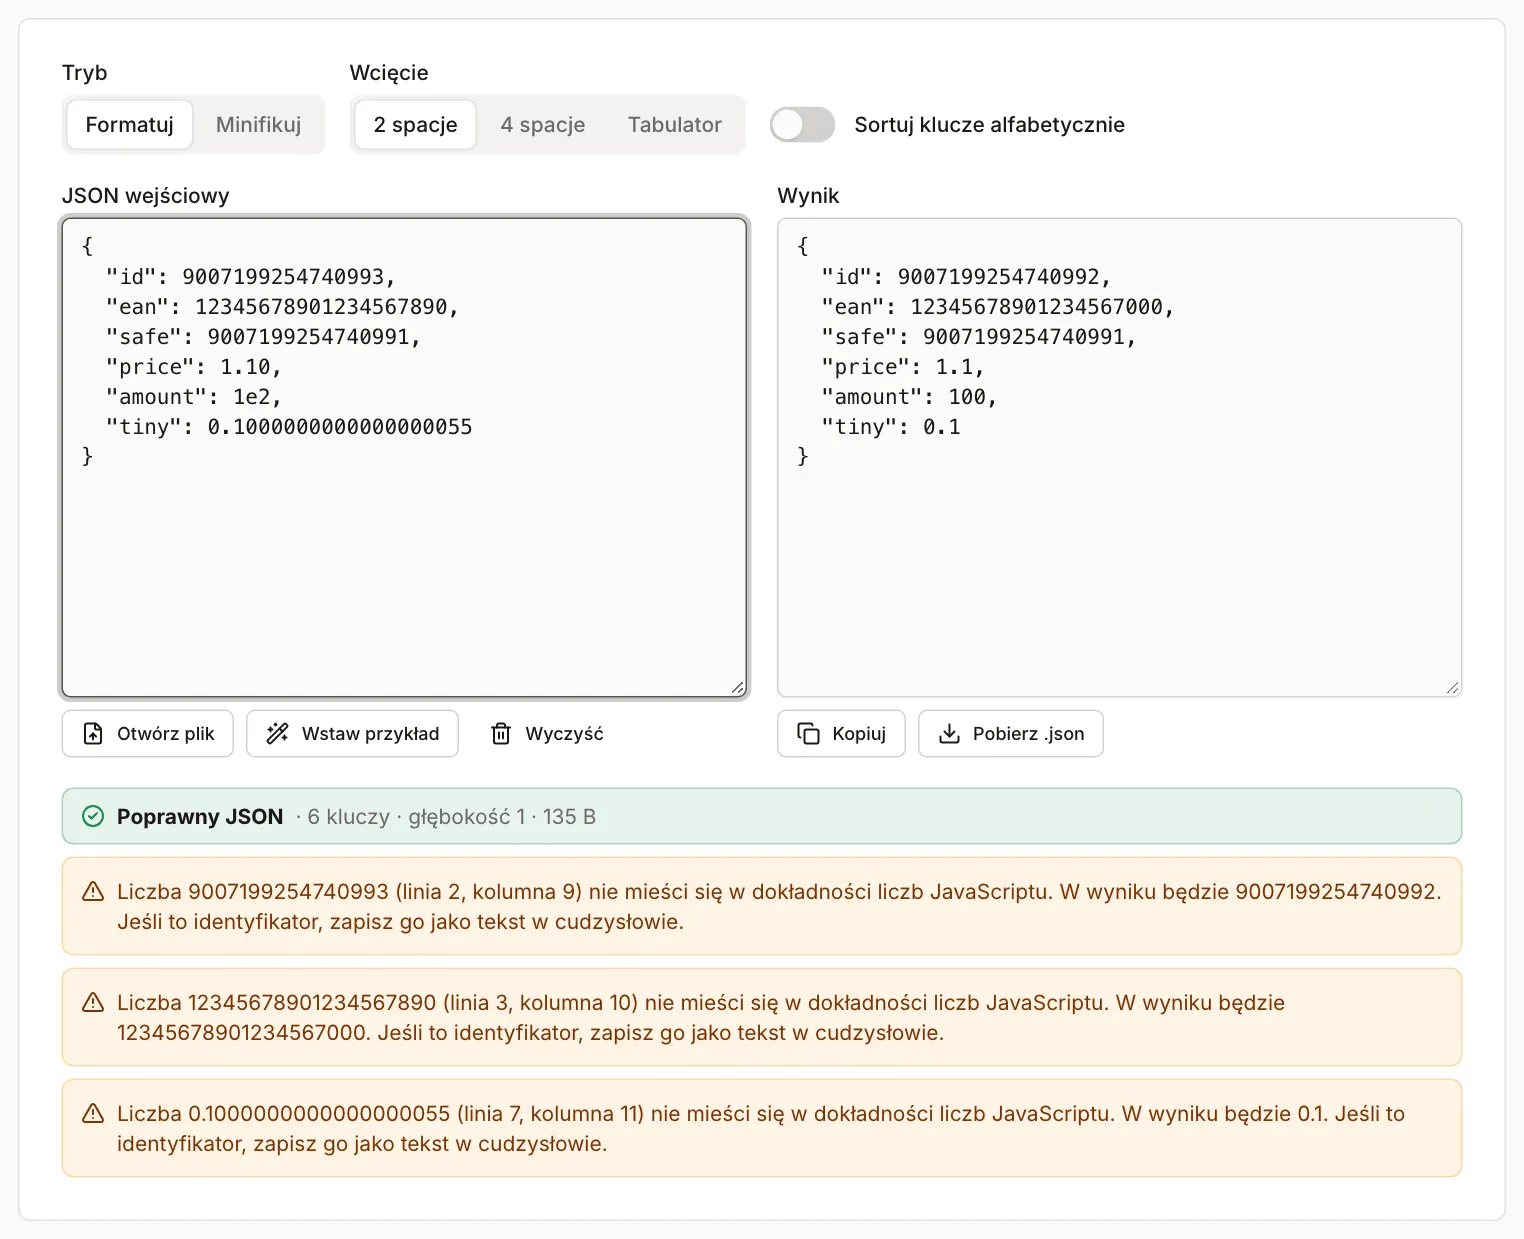
RFC 8259 w sekcji 6 zaznacza, że liczby całkowite od -(2^53)+1 do (2^53)-1 mają dokładne wartości, na które zgodzą się różne implementacje. Poza tym zakresem wynik zależy od programu. Ostrzeżenie wyjaśnia, co będzie w wyniku (np. „W wyniku będzie 9007199254740992”) i radzi zapisać identyfikator jako tekst w cudzysłowie. Zera końcowe i zapis wykładniczy (1.10, 1e2) nie są ostrzegane, bo zmienia się tylko zapis, a nie wartość. Dla numerów, identyfikatorów i kodów (EAN, numery kont, ID z baz danych) zapisuj wartość jako tekst: plik z "id": "9007199254740993" wraca bez zmian.
Zera końcowe w ułamku nie zmieniają wartości, ale zmieniają zapis: 1.10 staje się 1.1. Jeśli ten zapis jest ważny (np. cena porównywana jako tekst), przechowuj ją jako tekst.
Druga pułapka to powtórzone klucze. W pliku z dwoma kluczami "paid" (true, a potem false) narzędzie pokazało „Poprawny JSON” i w wyniku zostawiło ostatnią wartość false, a pod spodem ostrzeżenie: „Klucz „paid” powtarza się w tym samym obiekcie (linia 5, kolumna 3). Wynik zachowa tylko ostatnią wartość”. Według RFC 8259 (sekcja 4) nazwy w obiekcie powinny być unikalne, a zachowanie przy powtórzeniach jest nieprzewidywalne. Decyzję, którą wartość zostawić, musisz podjąć sam.
Konwerter CSV-JSON w kierunku JSON do CSV ma tę samą cechę, ale też ostrzega. Wklejony dokument z liczbami z powyższej tabeli dał w CSV 9007199254740992 i 12345678901234567000, a pod ustawieniami pojawiły się ostrzeżenia, np. „Liczba 9007199254740993 (linia 2, kolumna 9) nie mieści się w dokładności liczb JavaScriptu. W CSV znajdzie się 9007199254740992”. W kierunku CSV do JSON liczby całkowite większe niż 2^53 - 1 zostają tekstem: 9007199254740993 trafiło do wyniku w cudzysłowie, razem z kodem 00-950. Błędny JSON w konwerterze też dostaje pozycję, np. „Niepoprawny JSON: linia 9, kolumna 3” z tym samym opisem co w formatowaniu, ale bez fragmentu ze znacznikiem ^. Przy powtórzonym kluczu konwerter, tak jak formatowanie, ostrzega, że w CSV zostanie tylko ostatnia wartość (w naszym teście paid = false).
Formatowanie czy minifikacja
Formatowanie dodaje wcięcia i podziały linii, minifikacja usuwa zbędne białe znaki. Żadne z nich nie naprawia dokumentu: błędny JSON nie zostanie sformatowany ani zminifikowany, dopóki walidator nie przepuści go bez błędów.
Plik testowy zamówienia ma 165 B. Po przetworzeniu w narzędziu:
| Tryb | Wynik |
|---|---|
| Minifikuj | 120 B |
| Formatuj, 2 spacje | 196 B |
| Formatuj, 4 spacje | 248 B |
Wynik po formatowaniu jest większy od pliku wejściowego, bo narzędzie rozwija też obiekty zapisane w jednej linii ({ "sku": "A-1", "qty": 2 }). Sformatowany JSON pasuje do przeglądania w edytorze i porównywania zmian, a minifikowany do wysyłania w żądaniach i zapisu w konfiguracji. Opcja „Sortuj klucze alfabetycznie” ułatwia porównanie dwóch wersji tego samego dokumentu, ale zmienia kolejność kluczy w wyniku.
Czego narzędzie nie robi
- Nie naprawia błędów samo. Pokazuje pierwszy błąd i opis, a poprawkę wprowadzasz Ty.
- Nie sprawdza zgodności ze schematem (JSON Schema), tylko składnię.
- Nie rozpoznaje JSON5 ani JSONC. Dokument z komentarzami zostanie uznany za błędny.
- Pomiary komunikatów przeglądarki dotyczą Chromium. W innych przeglądarkach angielski komunikat może brzmieć inaczej, a pozycję i polski opis wylicza własny walidator narzędzia.